Codex CLI (Mac/Linux)
Установите и настройте Codex CLI на Mac / Linux для подключения к API LMU AI, включая способ включения длинного контекста в 1M токенов в config.toml.
После установки Codex CLI создайте два файла конфигурации вручную (config.toml + auth.json), чтобы подключиться к API LMU AI — сторонний инструмент настройки не нужен.
Шаг 1 — Установите Node.js
Вам нужен Node.js 20+ — скачать: https://nodejs.org/en/download
Пройдите по шагам установщика, затем проверьте в терминале:
node --version
# A version number (e.g. v23.7.0) means it installed correctly
Шаг 2 — Установите Codex CLI
npm i -g @openai/codexЕсли возникают проблемы с сетью, сначала переключитесь на китайское зеркало:
npm config set registry https://registry.npmmirror.com
npm i -g @openai/codex
Проверьте установку:
codex --version
# A version number means it installed correctly
Шаг 3 — Создайте файлы конфигурации
Каталог конфигурации — ~/.codex/ (создайте его, если отсутствует; перезапишите любые старые файлы). Создайте/перезапишите в нём эти два файла:
config.toml
model = "gpt-5.4"
model_reasoning_effort = "xhigh"
disable_response_storage = true
sandbox_mode = "danger-full-access"
windows_wsl_setup_acknowledged = true
approval_policy = "never"
file_opener = "vscode"
model_provider = "codex"
web_search = "cached"
suppress_unstable_features_warning = true

[history]
persistence = "save-all"

[tui]
notifications = true

[shell_environment_policy]
inherit = "all"
ignore_default_excludes = false

[sandbox_workspace_write]
network_access = true

[features]
plan_tool = true
apply_patch_freeform = true
view_image_tool = true
unified_exec = false
streamable_shell = false
rmcp_client = true
elevated_windows_sandbox = true

[profiles.auto-max]
approval_policy = "never"
sandbox_mode = "workspace-write"

[profiles.review]
approval_policy = "on-request"
sandbox_mode = "workspace-write"

[notice]
hide_gpt5_1_migration_prompt = true

[model_providers.codex]
name = "codex"
base_url = "https://api.lmuai.com"
wire_api = "responses"
requires_openai_auth = true
auth.json
{
  "OPENAI_API_KEY": "your sk- key generated in the console"
}
Шаг 4 — Запустите Codex CLI
После сохранения файлов конфигурации снова откройте терминал и выполните следующее, чтобы запустить и автоматически войти в систему:
codex --dangerously-bypass-approvals-and-sandboxИли короткую форму:
codex --yoloЭта команда запуска пропускает проверки безопасности, поэтому вам не нужно подтверждать каждый автоматически выполняемый шаг.
При успешном запуске интерфейс показывает текущую модель как gpt-5.4 xhigh (модель, заданную полем model в config.toml).
О переключении моделей
Если вы случайно переключились на другую модель в сессии, измените поле model в ~/.codex/config.toml обратно на gpt-5.4 и перезапустите терминал, чтобы восстановить её.
Включение контекста 1M в Codex (необязательно)
gpt-5.4 поддерживает длинное окно контекста в 1M токенов (272K по умолчанию), полезное для обзора больших репозиториев, анализа длинных логов и межфайлового рефакторинга. Codex не включает окно 1M по умолчанию; вы должны явно объявить его в config.toml.
Как настроить: добавьте две строки в config.toml
Отредактируйте ~/.codex/config.toml и добавьте следующее на верхнем уровне (перед любой [секцией], например, сразу после model = "gpt-5.4"):
model_context_window = 1000000
model_auto_compact_token_limit = 900000
Сохраните, снова откройте терминал и снова войдите в Codex, чтобы применить это.
Справка по полям
| Поле | Назначение |
|---|---|
model_context_window | Объявляет используемое окно контекста модели в токенах; 1000000 — это 1M. Если не задано, используется значение модели по умолчанию (272K) |
model_auto_compact_token_limit | Порог в токенах, запускающий автоматическое сжатие истории; задайте его примерно как 90% от окна (900000 для 1M). Значения выше 90% окна ограничиваются Codex, поэтому большее число бессмысленно |
Проверьте, что настройка применилась
После повторного входа в Codex введите /status и проверьте, показывает ли context window около 1M (некоторые версии показывают около 950K — зарезервированный запас безопасности в 5% от Codex). Вы также можете использовать /statusline, чтобы добавить использование контекста в строку состояния для мониторинга в реальном времени.
Если вы используете CC Switch
Если вы управляете конфигурацией Codex с помощью CC Switch, добавьте те же две строки в его редактор конфигурации Codex и примените — эффект будет идентичным:
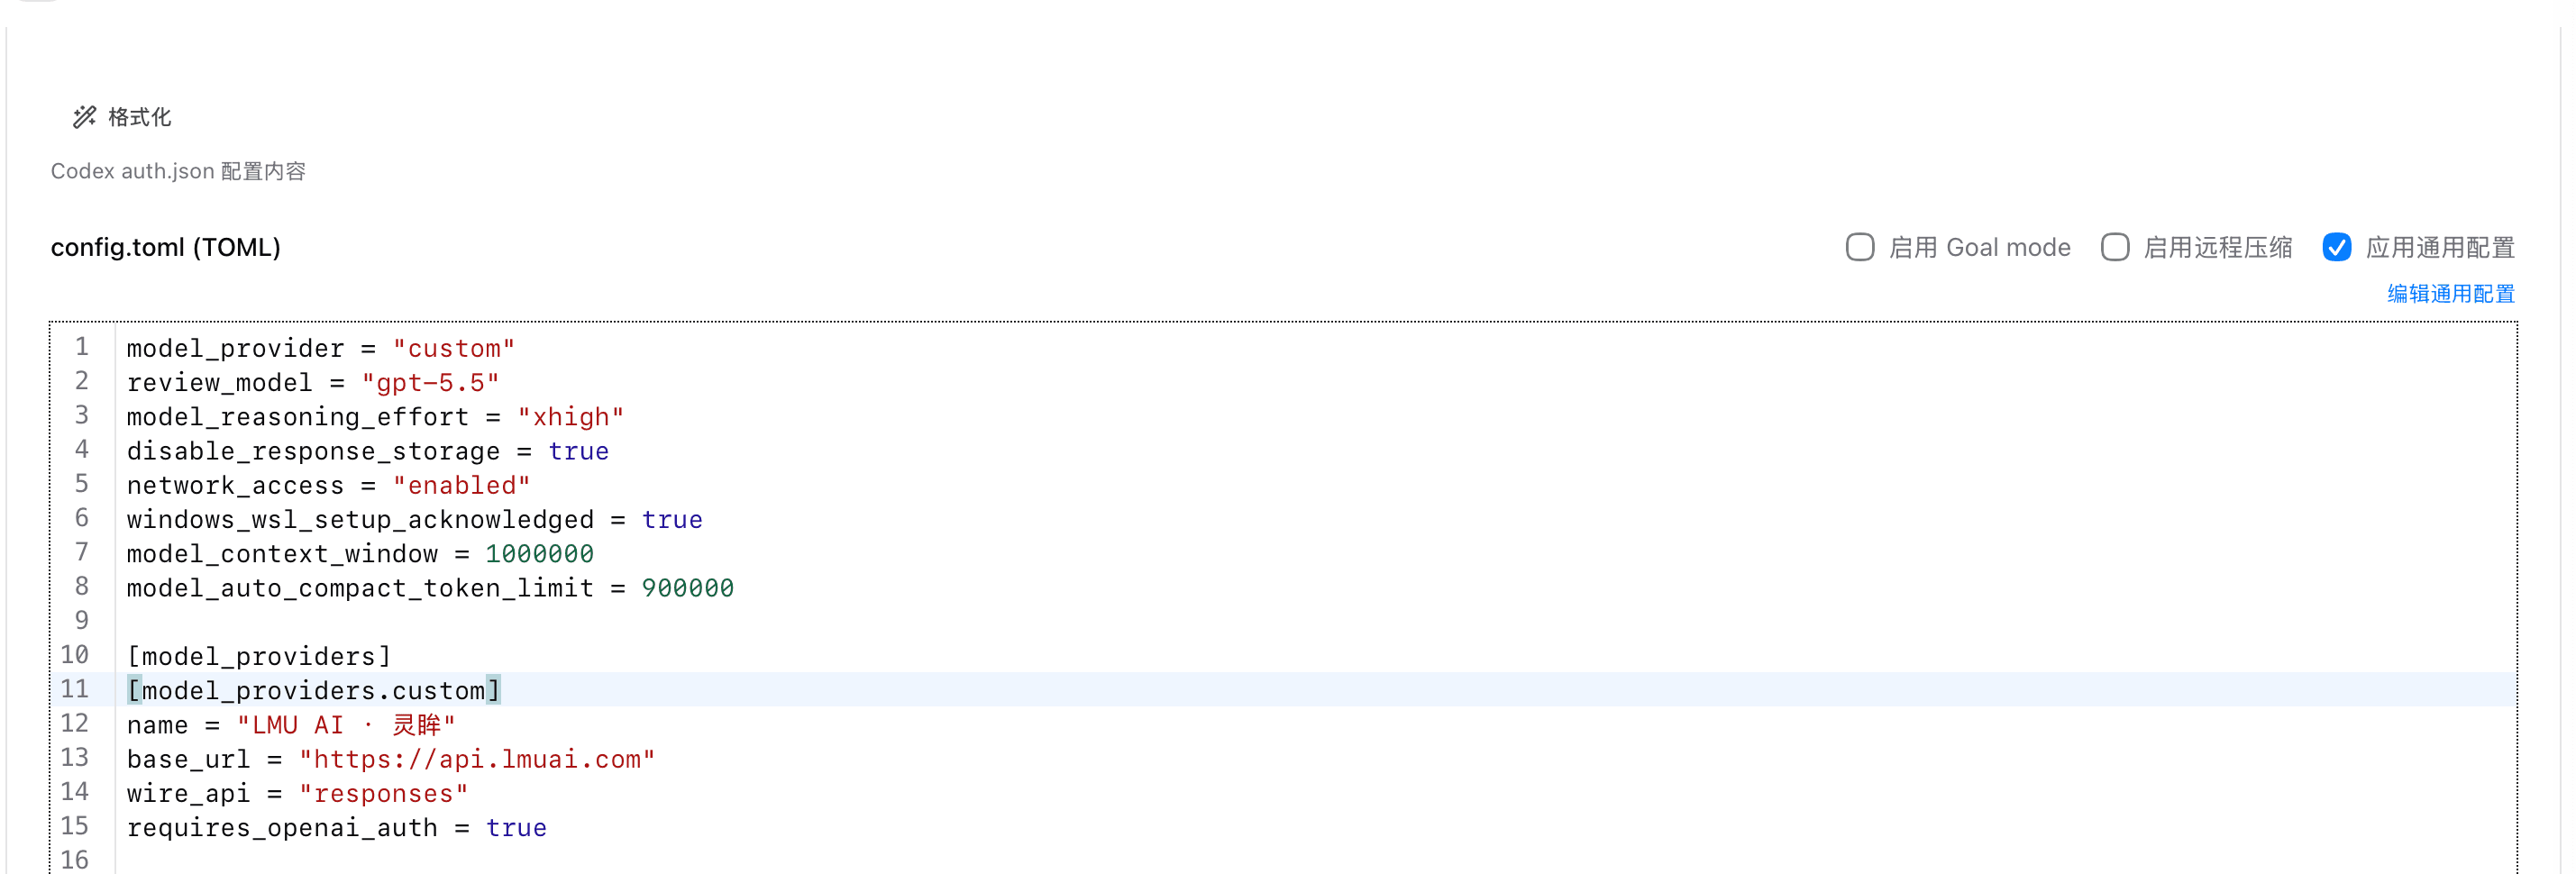
Замечания по использованию
- Должно быть на верхнем уровне: эти два поля не действуют внутри секции
[profiles.xxx](известное ограничение Codex); также размещайте их в пользовательском~/.codex/config.toml, поскольку проектный.codex/config.tomlможет игнорироваться - Поддержка моделей:
gpt-5.4иgpt-5.5поддерживают 1M по каналу API; модели вродеgpt-5.3-codexограничены 272K, и никакое значение конфигурации не может превысить собственный лимит модели - Более высокая стоимость: более длинный контекст использует больше токенов на запрос; часть выше 272K тарифицируется по более высокой ставке длинного контекста, поэтому не оставляйте его включённым ни для чего, кроме очень длинных задач
- Различия версий: некоторые новые версии Codex сначала считывают размер окна из каталога моделей; если
/statusвсё ещё показывает старое значение, обновитесь до последней версии (npm i -g @openai/codex@latest) и повторите попытку
Последнее обновление:
Получите API-ключ LMU AI и начните использовать Claude, Codex и другие инструменты
Бесплатная регистрация и гибкие тарифы. Один API-ключ для Claude Code, Codex CLI, Cursor, расширения VS Code, OpenCode, Cherry Studio и других ИИ-инструментов.
ЗарегистрироватьсяНастройка моделей GPT в Claude Code
Используйте модели GPT (например, gpt-5.6-sol) в Claude Code через LMU AI API: предварительные требования, конфигурация settings.json и переключение с помощью /model.
Codex CLI (Windows)
Установите и настройте Codex CLI в Windows для подключения к API LMU AI, включая включение длинного контекста на 1 млн токенов в config.toml.