Codex CLI (Mac/Linux)
Installez et configurez le Codex CLI sur Mac / Linux pour vous connecter à l'API LMU AI, y compris la façon d'activer le contexte long de 1M tokens dans config.toml.
Après avoir installé le Codex CLI, créez manuellement un seul fichier de configuration, config.toml (la clé y est placée dans un en-tête de requête), pour vous connecter à l'API LMU AI — aucun outil de configuration tiers n'est nécessaire.
Étape 1 — Installer Node.js
Vous avez besoin de Node.js 20+ — téléchargement : https://nodejs.org/en/download
Suivez les étapes de l'installateur, puis vérifiez dans le terminal :
node --version
# A version number (e.g. v23.7.0) means it installed correctly
Étape 2 — Installer le Codex CLI
npm i -g @openai/codexEn cas de problème réseau, basculez d'abord sur un miroir chinois :
npm config set registry https://registry.npmmirror.com
npm i -g @openai/codex
Vérifiez l'installation :
codex --version
# A version number means it installed correctly
Étape 3 — Créer les fichiers de configuration
Le répertoire de configuration est ~/.codex/ (créez-le s'il est absent ; écrasez les anciens fichiers). Créez/écrasez-y config.toml :
config.toml
model = "gpt-5.4"
model_reasoning_effort = "xhigh"
disable_response_storage = true
sandbox_mode = "danger-full-access"
windows_wsl_setup_acknowledged = true
approval_policy = "never"
file_opener = "vscode"
model_provider = "codex"
web_search = "cached"
suppress_unstable_features_warning = true

[history]
persistence = "save-all"

[tui]
notifications = true

[shell_environment_policy]
inherit = "all"
ignore_default_excludes = false

[sandbox_workspace_write]
network_access = true

[features]
plan_tool = true
apply_patch_freeform = true
view_image_tool = true
unified_exec = false
streamable_shell = false
rmcp_client = true
elevated_windows_sandbox = true

[profiles.auto-max]
approval_policy = "never"
sandbox_mode = "workspace-write"

[profiles.review]
approval_policy = "on-request"
sandbox_mode = "workspace-write"

[notice]
hide_gpt5_1_migration_prompt = true

[model_providers.codex]
name = "codex"
base_url = "https://api.lmuai.com"
wire_api = "responses"

[model_providers.codex.http_headers]
Authorization = "Bearer your sk- key generated in the console"
La clé se place dans un en-tête de requête
- Remplacez « votre clé sk- générée dans la console » sur la dernière ligne par votre clé
sk-, en conservant une espace entreBeareret la clé, par ex.Authorization = "Bearer sk-xxxx" - Placez la section
[model_providers.codex.http_headers]tout à la fin du fichier, sans aucun autre réglage après elle - Les versions récentes de Codex n'ont plus besoin de
auth.json. Si vous en avez créé un avec l'ancien guide, le laisser en place est sans conséquence, ou vous pouvez le supprimer (conservez-le si vous utilisez la compétence de génération d'images de Codex App) - Si votre ancienne configuration contient
requires_openai_auth = truedans la section[model_providers.codex], supprimez simplement cette ligne
Étape 4 — Lancer le Codex CLI
Après avoir enregistré les fichiers de configuration, rouvrez le terminal et exécutez la commande suivante pour lancer et vous connecter automatiquement :
codex --dangerously-bypass-approvals-and-sandboxOu la forme courte :
codex --yoloCette commande de lancement ignore les approbations de sécurité, vous n'avez donc pas à approuver chaque étape exécutée automatiquement.
En cas de lancement réussi, l'interface affiche le modèle courant gpt-5.4 xhigh (le modèle défini par le champ model dans config.toml).
À propos du changement de modèle
Si vous changez de modèle par erreur pendant une session, remettez le champ model de ~/.codex/config.toml sur gpt-5.4 et redémarrez le terminal pour le restaurer.
Activer le contexte 1M dans Codex (optionnel)
gpt-5.4 prend en charge une fenêtre de contexte long de 1M tokens (272K par défaut), utile pour la revue de gros dépôts, l'analyse de longs journaux et les refactorisations multi-fichiers. Codex n'active pas la fenêtre 1M par défaut ; vous devez la déclarer explicitement dans config.toml.
Comment configurer : ajouter deux lignes à config.toml
Modifiez ~/.codex/config.toml et ajoutez ce qui suit au niveau racine (avant toute [section], par ex. juste après model = "gpt-5.4") :
model_context_window = 1000000
model_auto_compact_token_limit = 900000
Enregistrez, rouvrez le terminal et relancez Codex pour appliquer.
Référence des champs
| Champ | Rôle |
|---|---|
model_context_window | Déclare la fenêtre de contexte utilisable du modèle en tokens ; 1000000 correspond à 1M. Non défini, la valeur par défaut du modèle est utilisée (272K) |
model_auto_compact_token_limit | Le seuil en tokens qui déclenche la compaction automatique de l'historique ; réglez-le à environ 90 % de la fenêtre (900000 pour 1M). Les valeurs au-delà de 90 % de la fenêtre sont plafonnées par Codex, un nombre plus élevé est donc inutile |
Vérifier la prise en compte
Après être revenu dans Codex, tapez /status et vérifiez si context window affiche environ 1M (certaines versions affichent environ 950K — une marge de sécurité de 5 % réservée par Codex). Vous pouvez aussi utiliser /statusline pour ajouter l'utilisation du contexte à la barre d'état et la suivre en direct.
Si vous utilisez CC Switch
Si vous gérez la configuration Codex avec CC Switch, ajoutez les deux mêmes lignes dans son éditeur de configuration Codex puis appliquez — l'effet est identique :
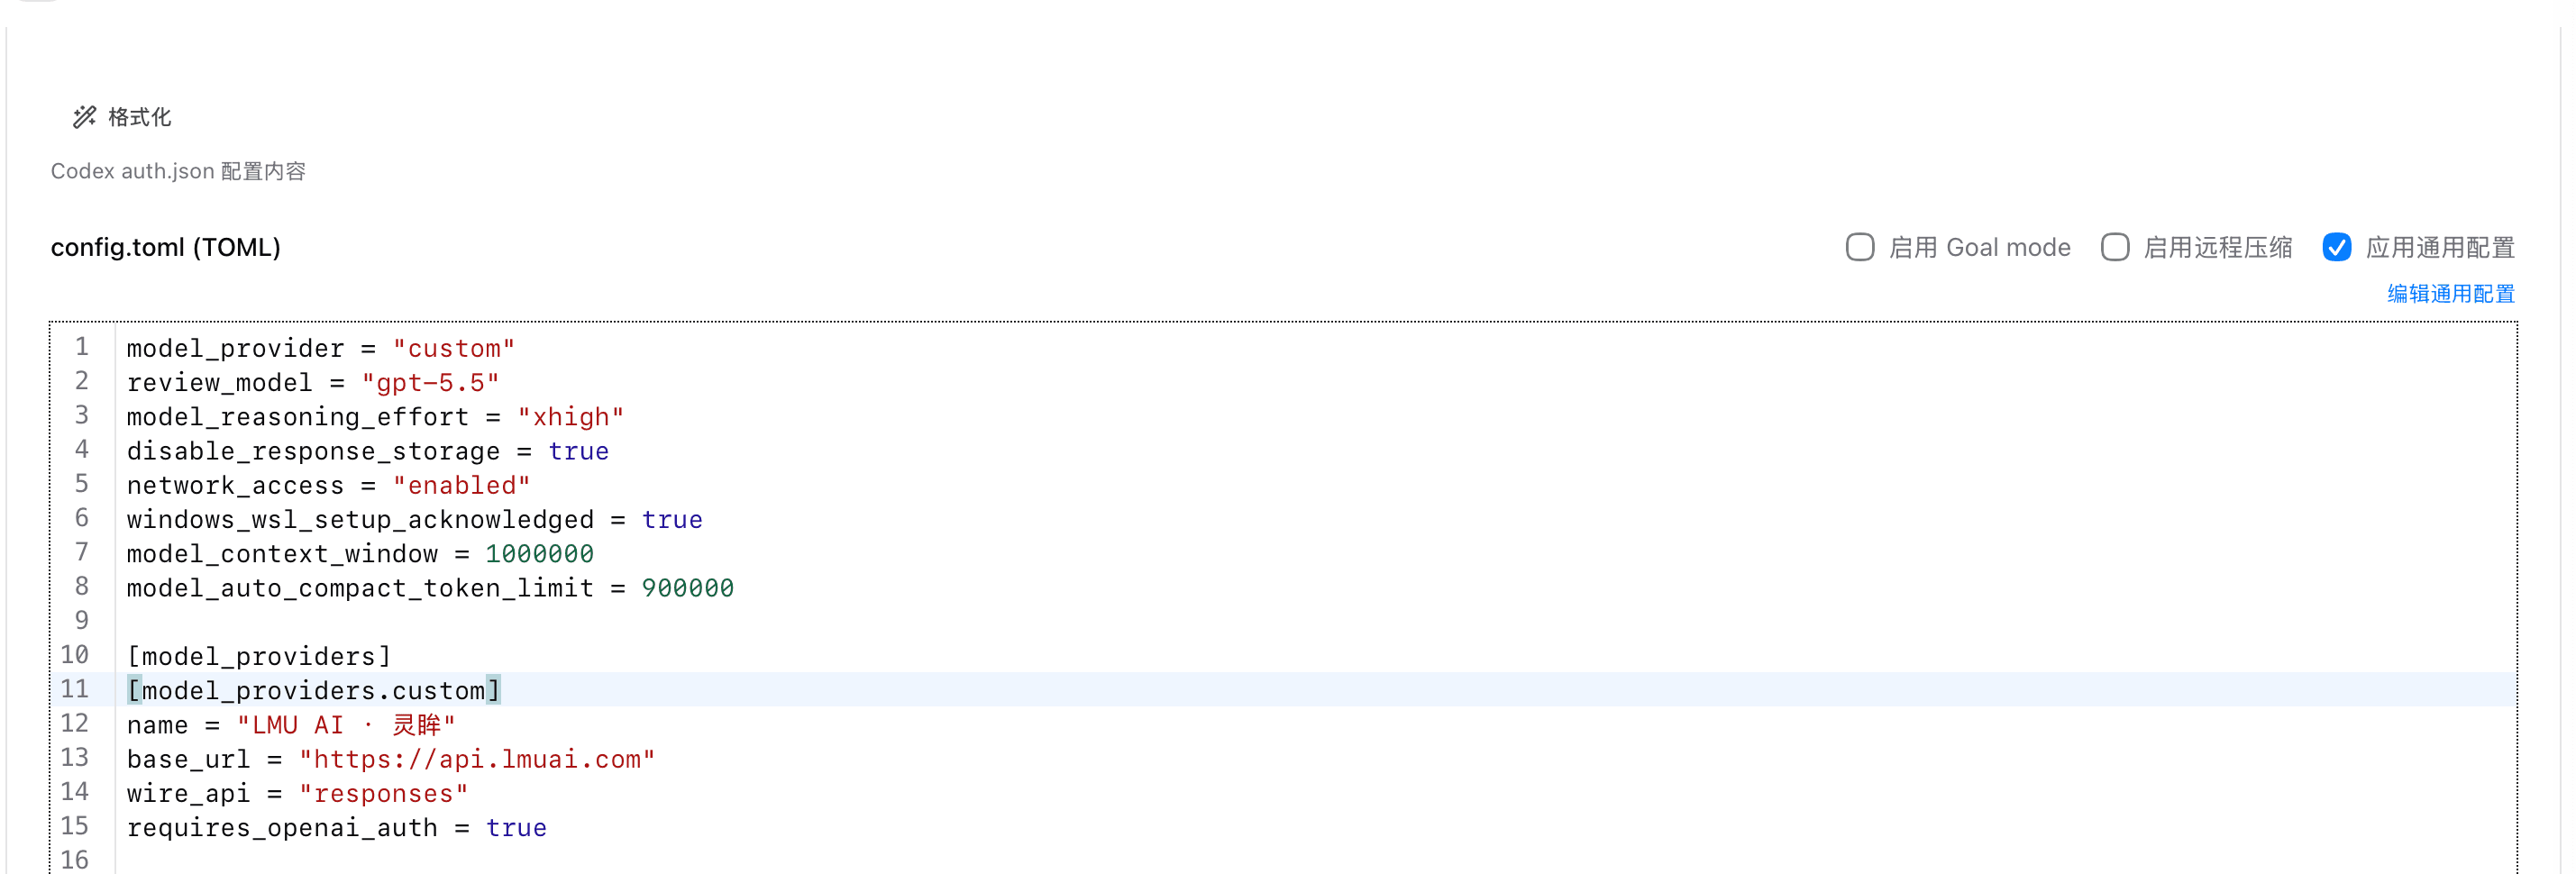
Notes d'utilisation
- Doivent être au niveau racine : ces deux champs n'ont aucun effet à l'intérieur d'une section
[profiles.xxx](limitation connue de Codex) ; placez-les également dans le~/.codex/config.tomlau niveau utilisateur, car un.codex/config.tomlau niveau du projet peut être ignoré - Prise en charge par les modèles :
gpt-5.4etgpt-5.5prennent en charge 1M via le canal API ; des modèles commegpt-5.3-codexsont plafonnés à 272K, et aucune valeur de configuration ne peut dépasser la limite propre du modèle - Coût plus élevé : un contexte plus long consomme plus de tokens par requête ; la portion au-delà de 272K est facturée au tarif supérieur du contexte long, ne le laissez donc pas activé en dehors des tâches très longues
- Différences de version : certaines versions récentes de Codex lisent d'abord la taille de la fenêtre dans le catalogue de modèles ; si
/statusaffiche toujours l'ancienne valeur, mettez à jour vers la dernière version (npm i -g @openai/codex@latest) et réessayez
Dernière mise à jour :
Obtenez une clé API LMU AI et utilisez Claude, Codex et plus encore
Inscription gratuite et forfaits flexibles. Une seule clé API pour Claude Code, Codex CLI, Cursor, l'extension VS Code, OpenCode, Cherry Studio et d'autres outils d'IA.
S'inscrireConfigurer les modèles GPT dans Claude Code
Utilisez les modèles GPT (par ex. gpt-5.6-sol) dans Claude Code via l'API LMU AI : prérequis à planifier, la configuration settings.json et le changement via /model.
Codex CLI (Windows)
Installez et configurez le Codex CLI sous Windows pour vous connecter à l'API LMU AI, avec la méthode pour activer le contexte long de 1M tokens dans config.toml.